Wat is PrivaSearch?
Kort antwoord
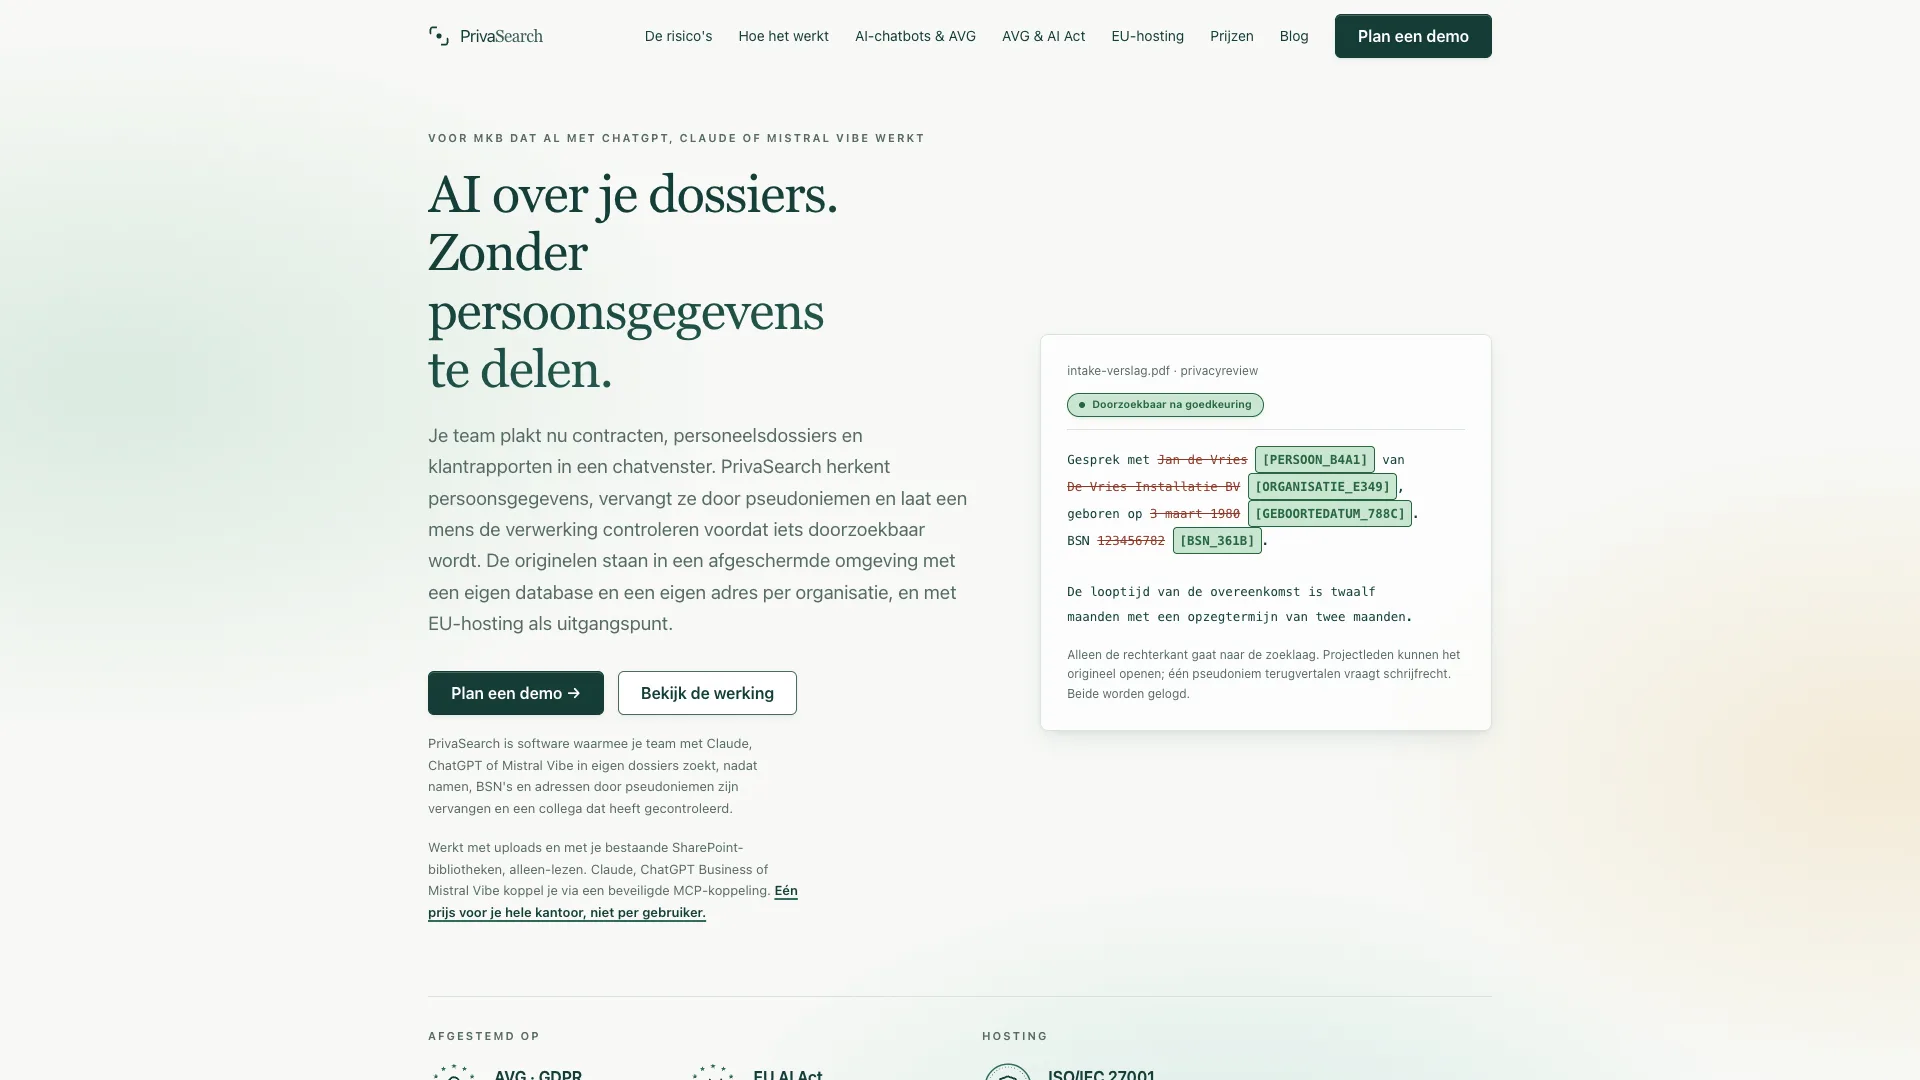
PrivaSearch is een omgeving die tussen je dossiers en je AI-assistent zit. Het vervangt namen, BSN's, adressen en andere persoonsgegevens door vaste pseudoniemen, laat een collega die tekst controleren en maakt pas daarna passages doorzoekbaar: voor het team en, via een beveiligde MCP-koppeling, voor Claude, ChatGPT Business of Mistral Vibe. Elke stap wordt vastgelegd.
Het begon met een vraag van een klant: kunnen we binnen de AVG met ChatGPT op onze dossiers werken? Het eerlijke antwoord was nee, niet zonder meer. Een zakelijk abonnement zet training uit en levert een verwerkersovereenkomst, maar alle persoonsgegevens in een geüpload document gaan onbewerkt mee. Dat hebben we uitgebreid beschreven in documenten uploaden in ChatGPT of Claude. Een kant-en-klaar product dat dit oploste voor een klein kantoor, zonder minimumafname, vonden we niet.
Dus bouwden we het, en omdat dezelfde vraag speelt bij juristen, adviseurs, HR-afdelingen en in de zorg, niet als maatwerk voor één organisatie maar als eigen product: PrivaSearch. Dit artikel gaat niet over de features, die staan op de casepagina. Het gaat over de zes ontwerpkeuzes die bepalen of zo'n omgeving werkelijk beschermt, of alleen zo voelt. Ze zijn ook bruikbaar als checklist als je een andere oplossing beoordeelt.
Keuze 1: persoonsgegevens herkennen we zelf, niet bij een AI-aanbieder
Een opvallend aantal privacyfilters stuurt de tekst eerst naar een taalmodel in de cloud om daar de persoonsgegevens te laten vinden. Dan heb je het probleem verplaatst, niet opgelost: het volledige document is alsnog bij een derde geweest.
PrivaSearch herkent persoonsgegevens daarom binnen de eigen omgeving, in twee lagen:
- Vaste patronen voor alles met een herkenbare vorm. E-mailadressen, IBAN's, BSN's met elfproef, postcodes, telefoonnummers, kentekens, btw- en KvK-nummers, en geboortedata als de context erop wijst. De elfproef is geen detail: zonder die controle markeer je elk getal van negen cijfers als BSN, en dan wordt een dossier met factuurnummers onleesbaar.
- Een taalmodel in een eigen dienst voor wat geen vaste vorm heeft: namen van personen, organisaties en adressen. Dat model draait naast de applicatie, niet bij een externe aanbieder.
Er is één plek waar die regel niet vanzelf opgaat, en die benoemen we liever dan dat we hem wegmoffelen: scans. Een PDF zonder tekstlaag moet eerst door OCR, en de OCR-dienst die we daarvoor kunnen gebruiken is extern. De scan gaat dan als origineel de deur uit, vóór de pseudonimisering. Daarom staat OCR standaard uit en wordt een afbeelding zonder OCR bij upload geweigerd. Een organisatie die het aanzet, doet dat bewust en kan dat in haar DPIA meewegen.
Keuze 2: hetzelfde pseudoniem voor dezelfde persoon
Een dossier waarin elke naam is vervangen door "[NAAM]" is privacyvriendelijk en volkomen nutteloos. Wie tekende namens wie? Welke klant hoort bij welke factuur? Die verbanden zijn precies waar je een AI-assistent voor wilt inzetten.
PrivaSearch geeft gelijk geschreven waarden binnen een project daarom steeds hetzelfde pseudoniem. Zo blijft "[PERSOON_A4F2] tekent namens [ORGANISATIE_E349]" voor een assistent net zo bruikbaar als het origineel, en komt dezelfde persoon in document drie onder hetzelfde label terug als in document één. De zoekvraag van een gebruiker wordt op dezelfde manier gepseudonimiseerd, zodat die de juiste passages blijft vinden.
De koppeling tussen pseudoniem en origineel staat in een gescheiden kluis met een eigen sleutel. Het model krijgt die tabel nooit. Terugvertalen kan alleen in de applicatie zelf, vraagt schrijfrecht op het project en komt in het logboek.
Er zit een afweging in de vorm van het pseudoniem. Er valt iets te zeggen voor realistisch ogende vervangwaarden: een taalmodel leest een verzonnen naam gewoon als naam en redeneert er soepel mee door. Het voordeel van een label is dat het ondubbelzinnig is: een reviewer ziet in één oogopslag wat er vervangen is, en niemand verwart een verzonnen naam later met een echte. Bij dossiers waar een fout grote gevolgen heeft, vinden wij die duidelijkheid zwaarder wegen.
Keuze 3: een mens keurt goed, anders wordt niets doorzoekbaar
Dit is de keuze waar we het langst over hebben nagedacht, omdat hij het product trager maakt. Elk document moet door een privacyreview voordat het doorzoekbaar wordt. Een editor of manager van het project ziet origineel en gepseudonimiseerde tekst naast elkaar, vult aan wat gemist is en keurt expliciet goed.
De reden is simpel: automatische herkenning haalt het nooit helemaal. Een onafhankelijke vergelijking van open detectiemodellen uit juni 2026 kwam op Nederlandse tekst met de beste opzet uit op een score van 0,78. Dat is netjes, en het betekent ook dat er zonder controle structureel persoonsgegevens doorheen glippen. Een filter dat je blind vertrouwt, geeft vooral schijnzekerheid.
Twee details maken de review sluitend. De goedkeuring hoort bij een specifieke versie van het document: verandert de bron, dan vervalt de goedkeuring en begint de review opnieuw. En de detectie is uitdrukkelijk een advies, geen besluit. Dat klinkt als semantiek, maar het bepaalt wie verantwoordelijk is: een collega die heeft gekeken, niet een algoritme.
Keuze 4: bij twijfel dicht
De meeste datalekken in software ontstaan niet in de hoofdroute, maar in de uitzonderingen: een verlopen token, een API die even niet antwoordt, een rechtencontrole die bij een fout stilletjes doorlaat. PrivaSearch is daarom fail-closed. Geen projectlidmaatschap, een gewijzigde bron, een verlopen bewaartermijn, een geblokkeerd account of een detectiedienst die niet reageert: dan geen toegang en geen verwerking.
Een klein voorbeeld van hoe ver dat doorgaat: wie een project, document of zoekresultaat opvraagt waar hij geen recht op heeft, krijgt een melding dat het niet bestaat, niet dat hij er geen toegang toe heeft. Ook het bestaan van een dossier kan gevoelige informatie zijn. Die weigering komt wel in het activiteitenlog van de organisatie.
Datzelfde principe zit in de opbouw. Elke organisatie heeft een eigen database en een eigen subdomein, zodat een fout in een query nooit gegevens van een andere organisatie kan opleveren. Aanmelden gaat met wachtwoord, een code uit een authenticator-app en, op een nieuw apparaat, een extra code per e-mail.
Keuze 5: de bron blijft de baas
De meeste organisaties hebben hun dossiers al ergens staan, vaak in SharePoint. Daar is per map en per document vastgelegd wie wat mag zien. Het laatste wat je wilt, is een tweede systeem met een tweede rechtenstructuur die langzaam uit de pas gaat lopen.
PrivaSearch kan documenten uit SharePoint Online importeren, maar alleen lezend. De koppeling heeft simpelweg geen methodes om iets te schrijven, en tests bewaken dat er alleen leesverzoeken naar SharePoint gaan. Belangrijker nog: bij elke uitlevering wordt live gecontroleerd of de gebruiker het document in SharePoint nog mag lezen. Trekt iemand daar een recht in, dan werkt dat direct door. Er is geen synchronisatie die eerst moet bijlopen.
Keuze 6: geen eigen chatbot, maar een koppeling met de assistent die je al hebt
De verleiding is groot om er een eigen chatvenster bij te bouwen. We deden het bewust niet. Een eigen chatbot loopt altijd achter op wat Anthropic, OpenAI en Mistral elke paar maanden uitbrengen, en medewerkers stappen dan alsnog over naar de app die ze kennen, met het dossier in de hand.
PrivaSearch levert daarom de passages, en de assistent van het team doet het denkwerk. Dat gaat via een MCP-server achter OAuth 2.1, met drie tools: projecten vinden, documenten doorzoeken en een bron lezen. De grenzen die in de webapplicatie gelden, gelden daar ook:
- Alleen vrijgegeven passages, binnen één project, met bronverwijzing en hooguit acht resultaten per zoekvraag.
- Nooit een origineel en nooit een bestand, alleen begrensde stukken gepseudonimiseerde tekst.
- Elke aanroep controleert de toegang opnieuw, en een assistent koppelen kan alleen vanuit een volledig aangemelde sessie.
Komt er volgend jaar een beter model, dan blijft de koppeling gewoon staan. Er is niets te migreren. Let wel op de platformgrenzen: bij ChatGPT werken eigen koppelingen alleen in de webversie, niet in de mobiele app.
Verantwoording hoort bij het product
Een privacylaag die werkt maar die je niet kunt aantonen, helpt je weinig als een klant of de Autoriteit Persoonsgegevens vraagt wat er met een dossier is gebeurd. Daarom zit het papierwerk in PrivaSearch zelf:
- Een activiteitenlog dat je niet ongemerkt kunt aanpassen. Elke download, terugvertaling en geweigerde toegang wordt vastgelegd, zonder documentinhoud. Er komen alleen regels bij, elke regel is met een hash aan de vorige gekoppeld en een geplande controle rekent die keten na. Meer over het principe lees je in audit trail in software.
- Bewaartermijnen per project, met gecontroleerde verwijdering en een juridische bewaarplicht die het opruimen tegenhoudt als dat nodig is.
- Een training AI-geletterdheid die medewerkers jaarlijks herhalen. Sinds februari 2025 moeten organisaties die AI inzetten volgens artikel 4 van de AI Act zorgen voor voldoende AI-geletterdheid bij hun mensen.
- Generatoren voor een AI-beleid en een DPIA-startdocument voor deze verwerking. Dat zijn startdocumenten om mee verder te gaan, geen juridisch advies. Hoe je zo'n beleid opbouwt, staat in AI-beleid opstellen voor het mkb.
Wat PrivaSearch niet oplost
Eerlijkheid hoort bij een privacyproduct, dus ook de grenzen.
Wat iemand zelf typt, gaat naar de AI-aanbieder. Schrijft een medewerker in Claude "zoek alles over Jan de Vries", dan heeft de aanbieder die naam ontvangen voordat PrivaSearch iets kan doen. De zoekvraag wordt in PrivaSearch wel gepseudonimiseerd, maar het bericht in de chat is dan al verstuurd. De praktische afspraak: verwijs naar projecten en dossiers, niet naar personen.
Een omgeving die je kunt omzeilen, beschermt alleen wie hem gebruikt. Sleept iemand het originele dossier alsnog in een chatvenster, dan helpt geen enkele koppeling. Dat vraagt om een gebruiksafspraak en, waar het echt niet mis mag gaan, om het blokkeren van uploads naar AI-diensten op de werkplek. Ook daar gaan we in het artikel over documenten uploaden verder op in.
Pseudonimiseren is geen anonimiseren. Voor jouw organisatie blijven het persoonsgegevens, want jij hebt de sleutel. Het Hof van Justitie oordeelde in 2025 in de zaak EDPS tegen de Gemeenschappelijke Afwikkelingsraad dat gepseudonimiseerde gegevens voor een ontvanger die ze redelijkerwijs niet kan herleiden geen persoonsgegevens hoeven te zijn. Dat verkleint het risico van wat er naar de AI-aanbieder gaat, maar ontslaat je niet van een grondslag, een informatieplicht en een DPIA.
Mijn kijk hierop
Wat me bij het bouwen het meest opviel: de techniek om persoonsgegevens te herkennen is het makkelijke deel. Het moeilijke deel zit in alles eromheen. Wat gebeurt er als het brondocument verandert? Wat als iemand uit dienst gaat en zijn SharePoint-rechten kwijtraakt? Wat als de detectiedienst om drie uur 's nachts even niet antwoordt? Elk van die vragen heeft een antwoord dat het product iets trager of strenger maakt, en elke keer kozen we voor streng.
De menselijke review is daar het duidelijkste voorbeeld van. Het zou mooi zijn als je honderd documenten kunt uploaden en een minuut later alles kunt doorzoeken. Maar een organisatie die met vertrouwelijke dossiers werkt, wil niet kunnen zeggen dat een algoritme het waarschijnlijk goed heeft gedaan. Ze wil kunnen zeggen dat een collega heeft gekeken.
Dezelfde keten zetten we ook in als maatwerk, voor organisaties die een eigen, afgeschermde AI-omgeving willen op hun eigen documenten of bronsystemen. Of je nu PrivaSearch gebruikt of iets laat bouwen: leg de zes keuzes uit dit artikel naast elke oplossing die je overweegt. Als een leverancier er drie niet kan beantwoorden, weet je genoeg.
— Jasper
Zo helpt Coding Agency hierbij
Wil je met AI op vertrouwelijke dossiers werken op een manier die je aan een klant of toezichthouder kunt uitleggen? Bekijk hoe we PrivaSearch bouwden, of laten we samen kijken of PrivaSearch past of dat een eigen omgeving op maat beter aansluit bij je bronsystemen. Neem contact op voor een vrijblijvend gesprek.